这次去新西兰玩了十几天,回来之后,内存卡里攒下了几百GB的4K视频素材。
拍的时候很开心,回来一想到要剪,就有点头大。整理素材、找片段、剪掉废话、配音乐、加字幕,每一步都要花时间。偏偏我已经取消了Final Cut Pro的订阅,也不太想为了这几期视频再开一次。
于是,我试着让AI帮我剪。把之前手动剪辑的工作流交给了AI Agent(ChatGPT Work)。
先让AI跟着我的工作流走
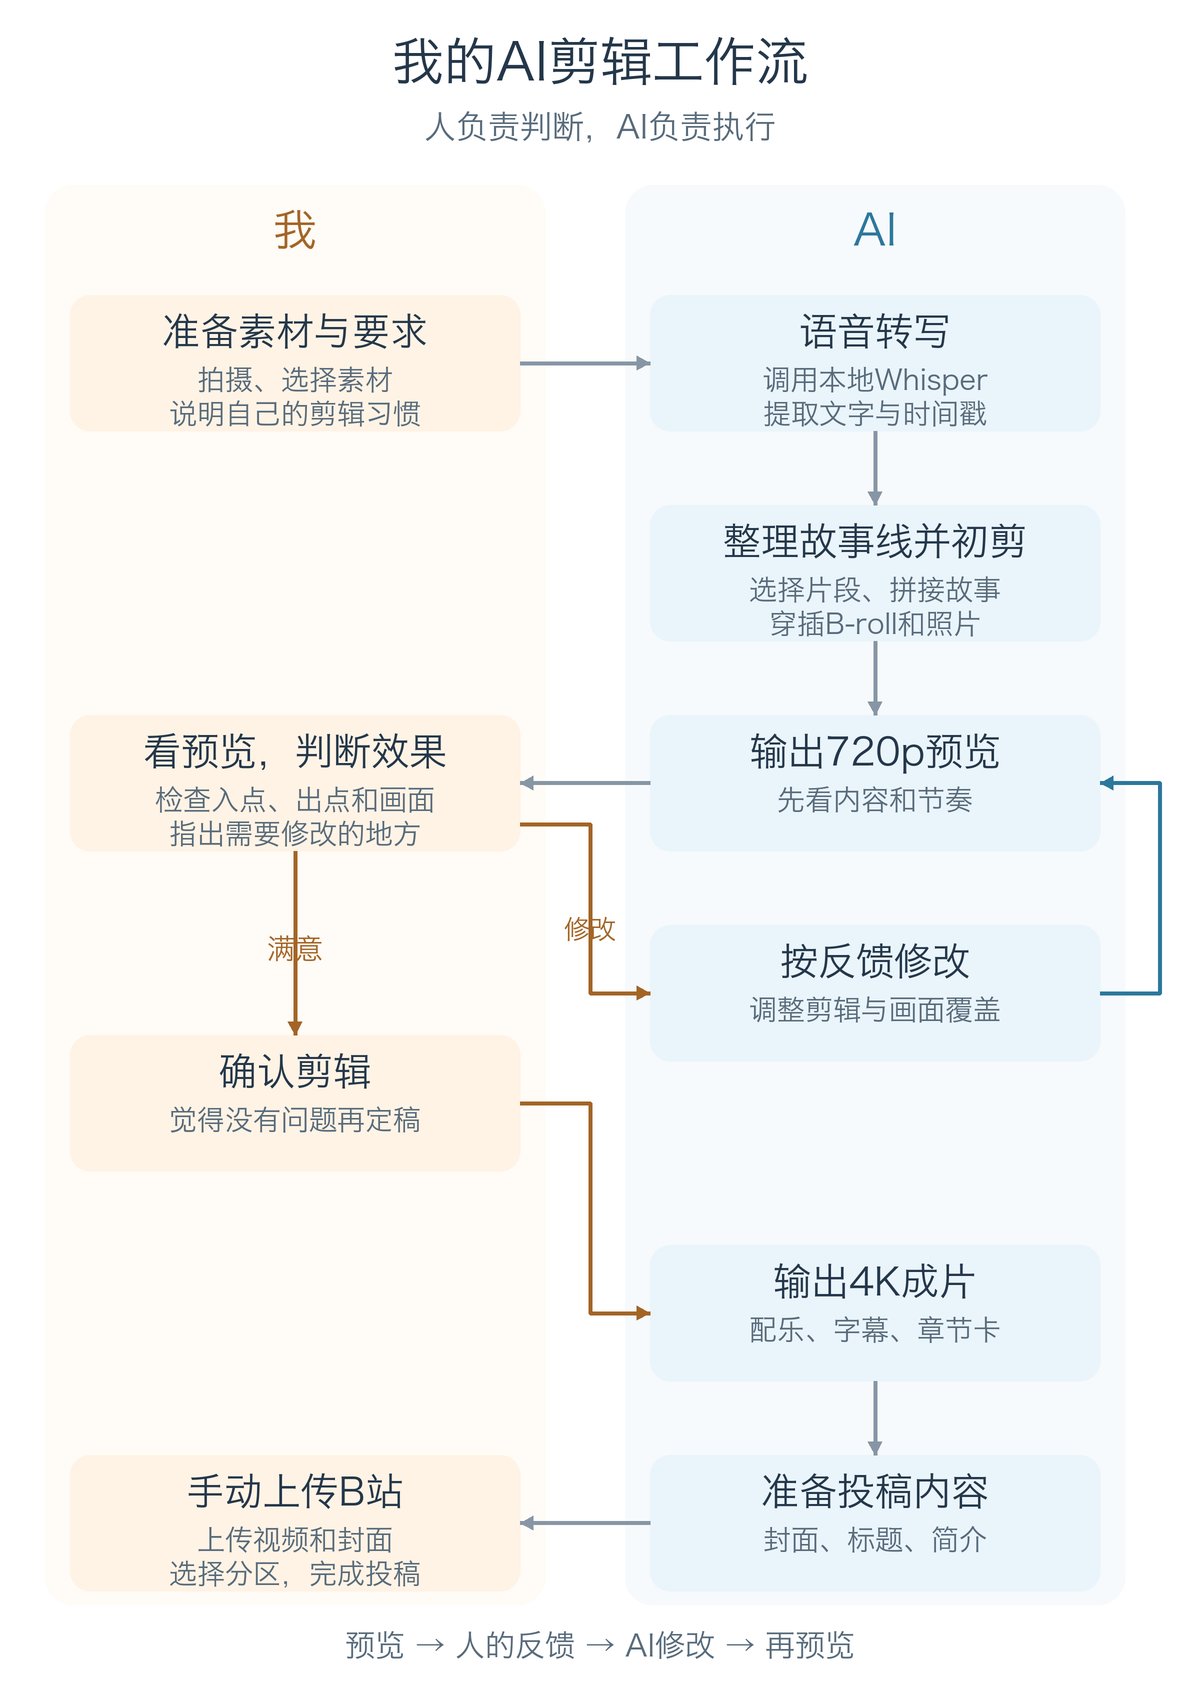
我平时剪旅行视频,习惯先按时间把素材排好,看看自己一路上说了什么,再把风景画面作为B Roll穿插进去。这次也沿用了这个思路。
第一步,把需要的时间段的素材复制到电脑上。确认拷贝完成,就可以把内存卡弹出来,后面的处理都在电脑里进行。
接着,让AI调用本地的Whisper模型,把视频里的说话内容转成文字。有了这些文字,它就能大致理出这一天去了哪里、发生了什么,顺着我拍摄时的讲述组织故事线。
故事线排好之后,再加上风景画面和照片。我会让它用那些没怎么说话的视频做B-roll,也可以穿插照片,照片的停留时间控制在一秒左右。
Whisper的转写结果带有时间戳,AI可以据此找到视频片段的入点和出点,再把这些片段和辅助画面拼接起来。
先看720p,满意了再出4K
虽然原始素材都是4K,我还是让它先生成一个720p的低清预览版。这个阶段主要看故事顺不顺、剪辑有没有问题,低清版本处理起来更快,也方便反复预览。
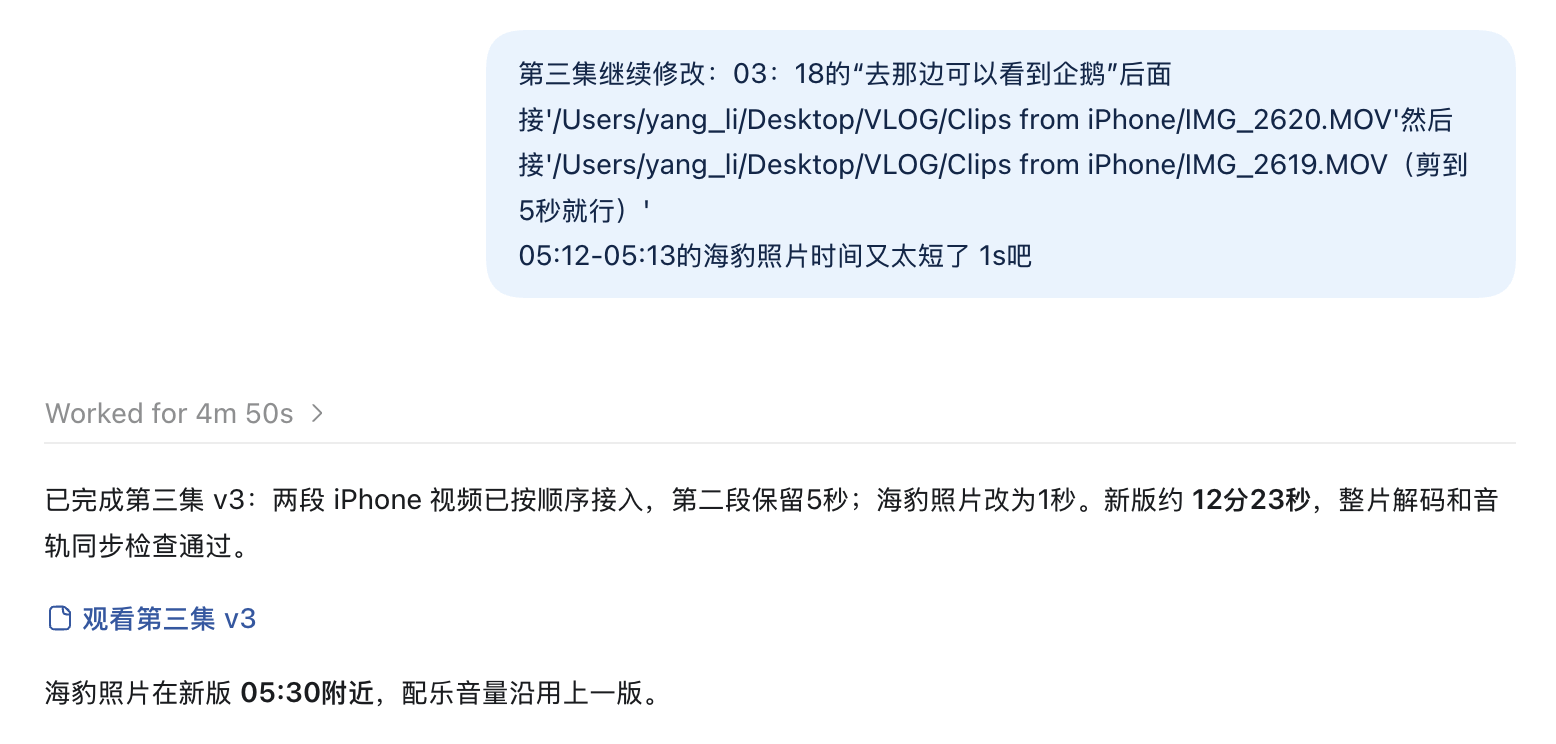
看完之后,我把具体问题告诉它:哪一处切早了,哪句话还没说完就被截掉了,哪一段B-roll的覆盖需要调整。它根据反馈再剪一版,我再看。
这样来回一两次,直到我觉得没有问题,再输出4K成片。
预览还是要自己看,节奏也要自己判断。发现问题,就直接告诉它,让它去改。
音乐、字幕、章节卡,也一起做了
除了剪辑,我还会让它调用本地的音乐模型Stability AI 的 Stable Audio 3 Medium,生成纯音乐,作为背景音乐使用。这类音乐的生成,本地算力还够用。
然后加上字幕,把字幕嵌入视频,再做章节卡,让每一段的内容更清楚。上传到B站时,也方便据此整理视频的分节。
封面沿用了我以前的风格:两张图片拼在一起,加上标题和对应国家的国旗。Codex参考之前的封面,调用图像生成工具来做这一期的封面图。
视频标题和简介也可以顺着已经整理好的故事线生成。最后,我去B站手动上传视频和封面,选好分区,填上这些信息,完成投稿。
入点和出点不准,是个麻烦
这次遇到最明显的问题,是剪辑的入点和出点选得不准。
有时一句话没有识别完整,有时听错了,有时干脆漏掉了。AI根据转写文字和时间戳去剪,前面的识别出了偏差,后面的剪辑就容易跟着出问题。
后来,我让它把Whisper从小模型换成中模型。处理更慢,也更吃算力,不过识别准确了一些。
部分识别错误的字幕,我会手动更正。还有一些实在听不清的地方,也就接受了。这几期VLOG主要是记录旅行、分享见闻,带一点流水账的感觉,我对它们的要求没有那么高。
以后想试试导出工程文件
如果之后想把剪辑做得更细,我想尝试让AI输出剪映或达芬奇(总之,免费软件)的工程文件。
这样,它先完成一轮剪辑,我再打开工程,微调片段的起止位置、画面和节奏,应该会更方便。这个方案我还没有在这次流程里完成,留着以后继续试。
就这次旅行记录来说,让AI按照我的工作流先剪,再根据反馈改几轮,已经够用了。